Un cliente dicta el número de un pedido, oye al asistente repetirlo y detecta un dígito equivocado. Puede intervenir para corregirlo antes de que termine la respuesta. Es un ejemplo de la conversación que OpenAI describe para GPT-Live-1.1, su modelo de voz en tiempo real. La empresa lo incorporó al registro de novedades de la API el 19 de noviembre de 2026 y anunció su disponibilidad para desarrolladores un día después.
La novedad de noviembre es para quienes desarrollan aplicaciones
La API permite conectar el modelo con una aplicación ajena a ChatGPT. OpenAI afirma que GPT-Live-1.1 ya se utilizaba en el modo de voz de ChatGPT Plus y Pro desde el 15 de octubre. Lo nuevo en noviembre es la posibilidad de incorporarlo a otras aplicaciones, no la aparición de un botón para quienes ya usan ChatGPT.
La documentación identifica el modelo como `gpt-live-1.1`. Si un equipo ya utiliza la API Live, puede seleccionar esa versión en la configuración de la sesión. Que se anuncie su disponibilidad no indica cuántas llamadas simultáneas admite un proyecto concreto. La ficha técnica especifica que las dos versiones tienen límites separados de sesiones simultáneas y remite a los límites de cada organización.
Escuchar mientras habla permite corregir sobre la marcha
La comunicación es bidireccional: el modelo puede recibir voz mientras produce audio. La persona que llama no tiene que esperar a que el asistente haga una pausa para corregir un número o cambiar de idioma. La documentación no presenta esa capacidad como exclusiva de la versión 1.1. La mejora que OpenAI atribuye a esta actualización se refiere a cómo maneja el habla en varios idiomas.
La empresa sostiene que la transcripción es más precisa y que el acento y la pronunciación son más consistentes al pasar de un idioma a otro. Son afirmaciones del proveedor, no resultados de una prueba independiente en portugués de Brasil. Tampoco garantizan que capte correctamente cualquier número de teléfono dictado en una calle ruidosa.
Conversar y recuperar un pedido son dos tareas
En el servicio de atención de una tienda, el modelo de voz puede pedir el número de un pedido. La búsqueda del registro puede quedar en manos del sistema que almacena los pedidos. La documentación describe esa delegación: la aplicación define cuándo hace falta consultar otro servicio o solicitar una acción fuera del modelo de voz.
Separar ambas tareas permite localizar un fallo. Si la persona dijo siete y el modelo entendió seis, el problema se produjo en la entrada. Si el número era correcto pero el sistema devolvió otro pedido, mejorar el reconocimiento de voz no lo arreglaría. Una prueba útil anota el código esperado, comprueba qué oyó el modelo y verifica por separado el registro devuelto.
La llamada abierta puede costar menos durante la espera
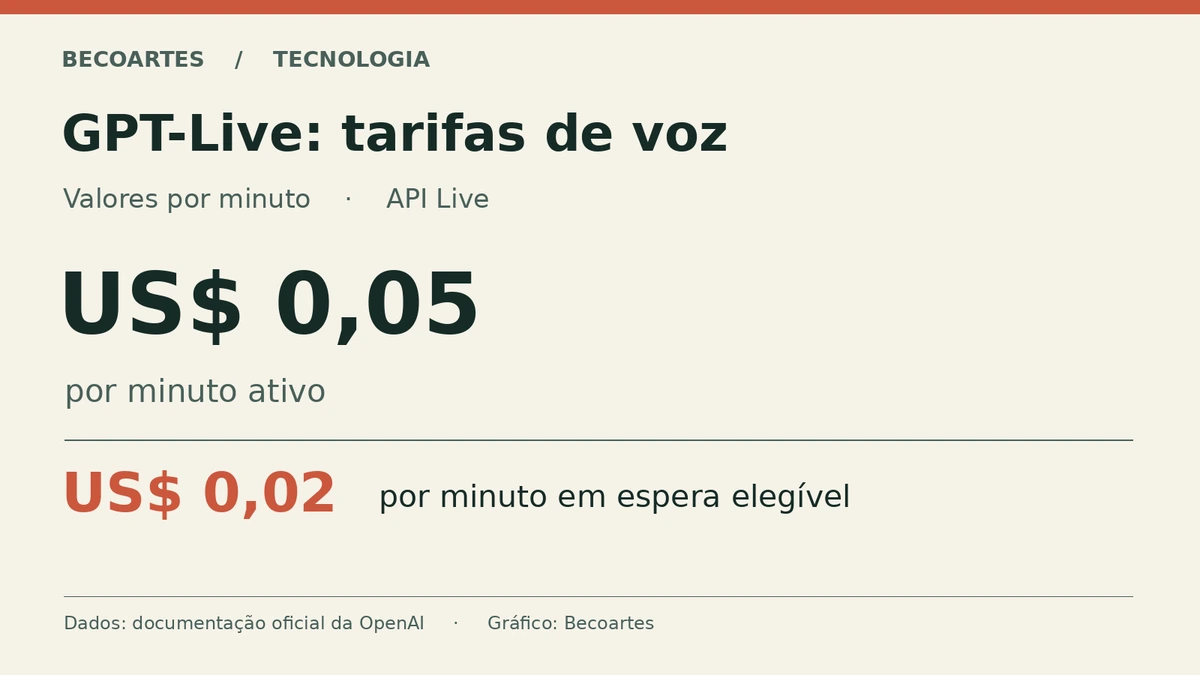
La tarifa activa es de cinco centavos de dólar por minuto. La de espera, de dos centavos, se aplica cuando el procesamiento queda suspendido en una sesión WebRTC. La configuración está disponible tanto para el modelo anterior como para la versión 1.1. La aplicación selecciona un periodo de inactividad de cinco a sesenta segundos. Pasado ese plazo, la llamada sigue abierta y el procesamiento vuelve a activarse cuando alguien habla.
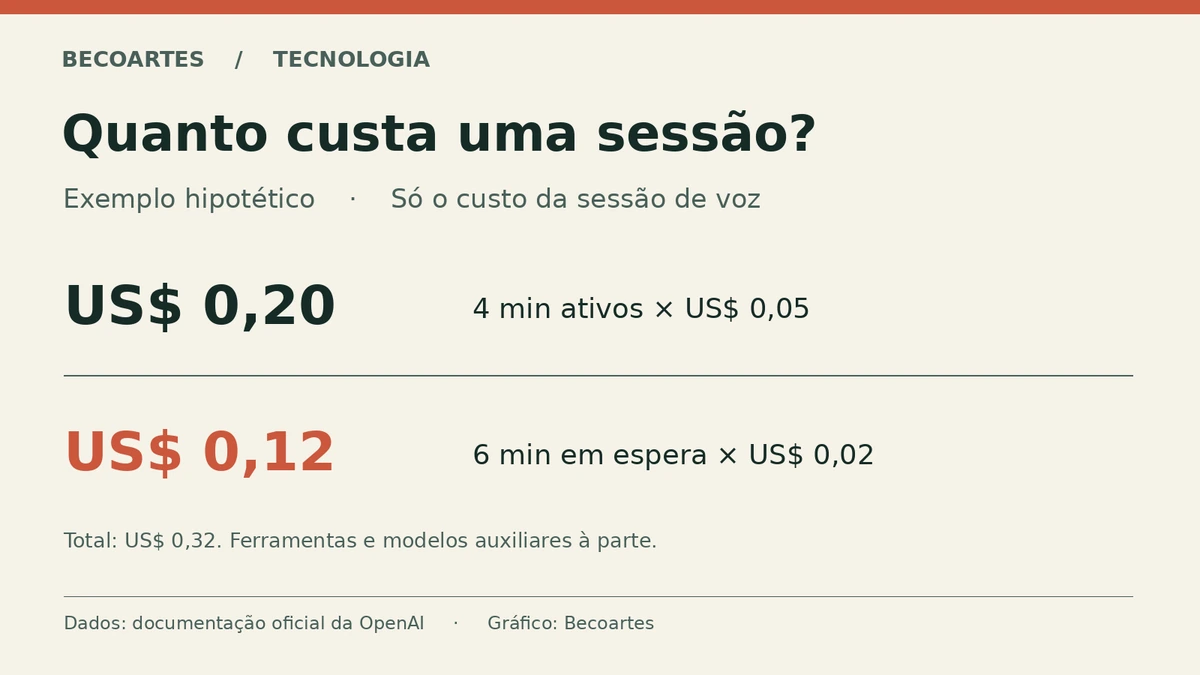
El silencio no garantiza por sí mismo que se aplique la tarifa reducida: el procesamiento debe haberse suspendido. Una sesión hipotética con cuatro minutos activos y seis en espera que cumplan la condición costaría 32 centavos. El cálculo no incluye modelos auxiliares ni herramientas. Es un ejemplo con las tarifas anunciadas, no una medición de una llamada.
Cómo saber si el cambio ayuda a una aplicación concreta
Una prueba piloto puede repetir el mismo guion con las dos versiones y anotar si el modelo captó el número sin correcciones, si encontró el registro correcto y si la persona tuvo que repetir la pregunta. También puede introducir cambios de idioma e interrupciones. El objetivo no es elegir la voz que suena mejor en una demostración, sino comprobar si el usuario consigue terminar la tarea.
La duración total tampoco basta para estimar gastos. Dos llamadas de diez minutos pueden contener distintos tiempos de actividad y espera, y una puede disparar más consultas que la otra. Medir por separado el tiempo y las operaciones permite evaluar la utilidad para ese servicio sin tomar las afirmaciones del proveedor como resultados observados.
Consulte la documentación
Consulte los requisitos y las condiciones de cobro en la ficha oficial.
Becoartes - Beco do Batman
Rua Gonçalo Afonso 99, Vila Madalena, São Paulo